String işlemleri
Programlarda birçok veri sayı değildir: adlar, e-posta adresleri, ürün kodları, şehir adları, dosya adları ve kullanıcı mesajları metin olarak tutulur. Python’da metin değerlerine string denir, türleri str’dir.
Bu hafta bir string’in karakterlerine erişmeyi, parçalarını almayı, metni temizlemeyi ve basit kontroller yapmayı öğreneceğiz. String metotlarını tek tek ezberlemeyeceğiz; metni adım adım dönüştürüp her adımda kontrol etmeye alışacağız.
Bu bölümün kapsamı
- İndeks ve negatif indeksle karaktere erişim
- Dilimlemede başlangıcın dâhil, bitişin hariç olması
- String’in değiştirilemez olması ve metotların yeni string döndürmesi
strip(),lower(),upper()ve TürkçeI/İsınırıin,startswith()veendswith()denetimlerinin farkısplit()vejoin()ile parçalama ve birleştirme- f-string ile biçimlendirme ve
:.2fdavranışı
- Düzenli ifadeler (
remodülü) - Unicode normalleştirme biçimleri
casefold()davranışının ayrıntıları
Bu başlıklar konunun devamıdır; ileride karşınıza çıkar ama bu derste ezberlemeniz beklenmiyor.
"İĞNE".lower() neden her zaman "iğne" vermez?
Gözle aynı görünen iki metin program için farklı olabilir. Örneğin " deniz" == "deniz" karşılaştırması False sonucunu verir, çünkü baştaki boşluk da bir karakterdir. Fazladan bir boşluk, büyük harf farkı ya da Türkçeye özgü bir harf çifti yüzünden karşılaştırma hata vermez ama yanlış sonuç döndürür.
String: karakterlerden oluşan bir değer
Aşağıdaki değişken bir string tutar:
sehir = "Samsun"Karakterleri soldan sağa numaralayalım:
S  a  m  s  u  n
0  1  2  3  4  5
Her karakterin sırasını gösteren bu numaraya indeks denir. Python’da indeksler 0’dan başlar.
sehir = "Samsun"

print(sehir[0])
print(sehir[1])
print(sehir[5])
Çıktı:
S
a
nAltı karakterlik bir string’in son geçerli pozitif indeksi 5’tir. sehir[6] yazmak IndexError hatası verir.
len() ile uzunluk
len() string içindeki karakter sayısını verir:
sehir = "Samsun"
print(len(sehir))
Sonuç 6’dır.
Son indeks her zaman uzunluktan bir eksiktir:
uzunluk = 6
son indeks = 5
Bu nedenle son karaktere pozitif indeksle ulaşmak için len(metin) - 1 kullanılabilir:
metin = "Python"
print(metin[len(metin) - 1])
Bunun daha kısa bir yolu da var: hemen aşağıda göreceğimiz negatif indeksleme ile son karakteri metin[-1] yazarak alabiliriz.
Negatif indeksler
Negatif indeksler sağdan sayar:
metin = "Python"

print(metin[-1])
print(metin[-2])
Çıktı:
n
o
-1 son karakteri gösterir.
Tahmin et: hangi karakterler yazılır?
Kodu çalıştırmadan önce sonucu tahmin edin:
Sonra hücreyi çalıştırıp tahmininizi doğrulayın.
Dilimleme (slicing)
Bir string’in tek bir karakterini alabildiğimiz gibi bir bölümünü de alabiliriz. Buna dilimleme denir:
metin = "Programlama"

print(metin[0:7])
Sonuç:
ProgramDilimlemede başlangıç indeksi dâhil, bitiş indeksi hariçtir.
metin[0:7]
      ↑ ↑
      | └─ 7 dahil değil
      └─── 0 dahil
Başlangıç veya bitiş boş bırakılabilir:
dosya = "rapor.pdf"

print(dosya[:5])
print(dosya[6:])
Çıktı:
rapor
pdf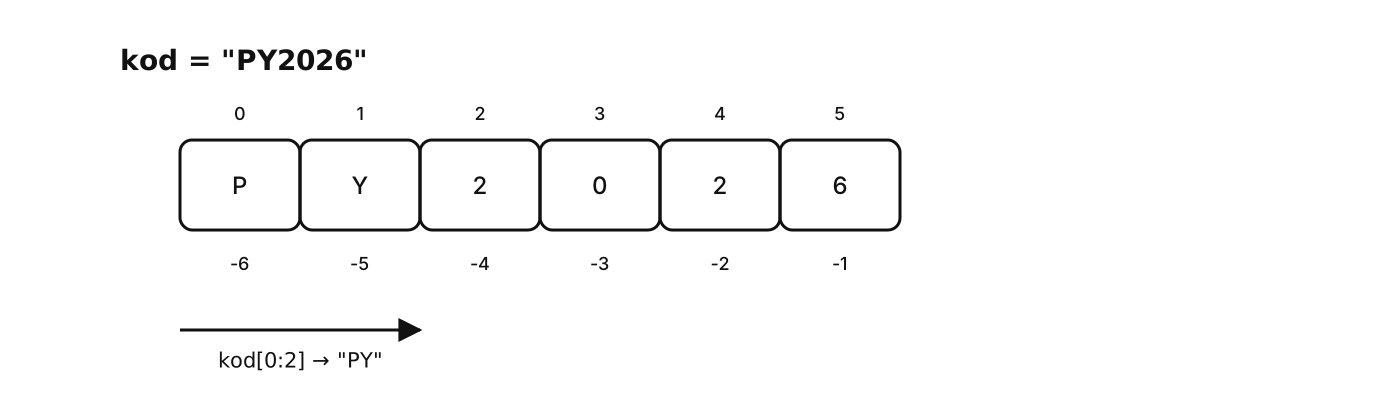
Alıştırma: ders kodunu parçalayın
"BLP101" değerinden ilk üç karakteri ve son üç karakteri ayrı değişkenlere alın.
Beklenen çıktı:
BLP
101
İlk üç karakter için ders_kodu[:3], son üç karakter için ders_kodu[-3:] kullanılabilir.
ders_kodu = "BLP101"

bolum = ders_kodu[:3]
numara = ders_kodu[-3:]

print(bolum)
print(numara)
String değerler değiştirilemez
Gelecek hafta bir listenin elemanlarını değiştirebildiğimizi göreceğiz. String’de ise tek bir karakteri doğrudan değiştiremeyiz:
metin = "kedi"
# metin[0] = "K"   # Bu işlem geçerli değildir.
Bunun yerine yeni bir string oluştururuz:
metin = "kedi"
yeni_metin = "K" + metin[1:]

print(yeni_metin)
Bir string oluşturulduktan sonra içeriği değişmez; bu yüzden string’lere değiştirilemez (immutable) denir. String metotları da var olan değeri değiştirmez, yeni bir string döndürür.
lower(), upper() ve strip()
Metin karşılaştırmalarında büyük-küçük harf ve gereksiz boşluklar sorun çıkarabilir.
girdi = "  Python  "

temiz = girdi.strip()
kucuk = temiz.lower()

print(temiz)
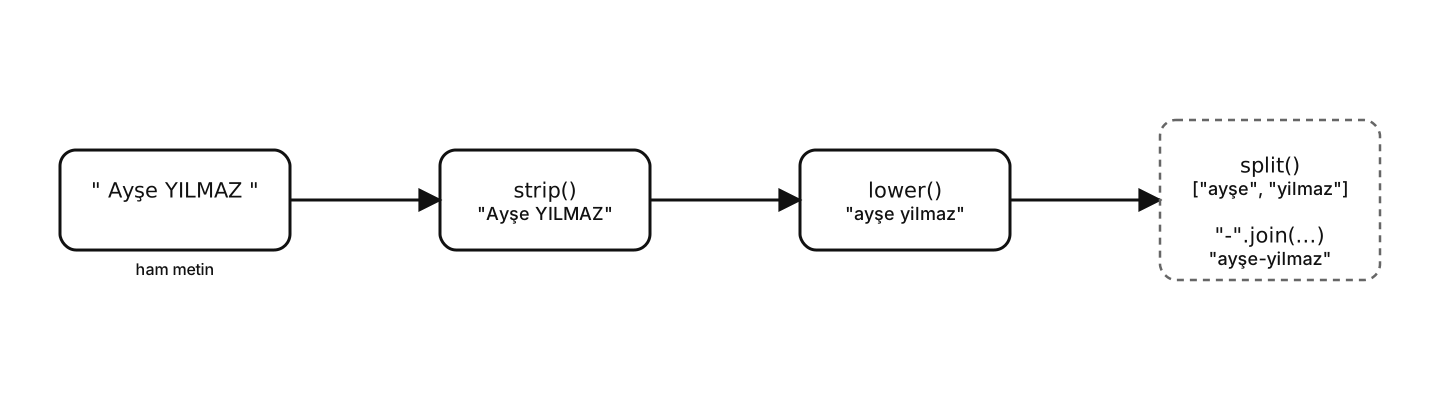
print(kucuk)strip()baştaki ve sondaki boşlukları kaldırır.lower()harfleri küçük harfe çevirir. Bunu, bütün diller için ortak olan Unicode kurallarına göre yapar (Unicode, bilgisayarların dünyadaki yazı sistemlerindeki karakterleri numaralandırdığı standarttır).upper()aynı kurallarla harfleri büyük harfe çevirir.
Metni karşılaştırmadan önce böyle ortak bir biçime getirmeye normalleştirme denir.
Şu koda dikkat edin:
metin = "Python"
metin.lower()

print(metin)
Burada metin hâlâ "Python"dır, çünkü lower() yeni bir string döndürür. Sonucu bir değişkene atamanız gerekir:
metin = metin.lower()Türkçe I / İ için önemli uyarı
Bilgisayarınızın dil ve bölge ayarı (yerel ayar) Türkçe olsa bile str.lower() ve str.upper() Türkçe kurallarını kullanmaz. İki metot da her dilde aynı çalışan Unicode dönüşümünü uygular. Bu dönüşüme İngilizcede locale-independent (yerel ayardan bağımsız) denir. Türkçede noktalı ve noktasız i ayrı harfler olduğu için bu fark gerçek veride sorun çıkarır.
Örneğin:
print("İĞNE".lower())
print("iğne" == "İĞNE".lower())
print("ISPARTA".lower())
print("istanbul".upper())
Python’da bu satırlar genellikle şu sonuçları verir:
"İĞNE".lower()      -> "i̇ğne"
"iğne" == ...       -> False
"ISPARTA".lower()   -> "isparta"
"istanbul".upper()  -> "ISTANBUL"
İlk sonuç ekranda iğne gibi görünebilir, ama i harfinden sonra gizli bir karakter daha vardır: birleşen nokta (U+0307), yani önündeki harfin üstüne eklenen nokta işareti. Bu yüzden iki metin gözle aynı görünse de eşit çıkmayabilir, karakter sayıları bile farklı olabilir.
Türkçede ise dönüşümler şöyle olmalıdır:
I→ıİ→ii→İı→I
casefold(), büyük/küçük harfi önemsemeden karşılaştırma yapmak için lower()’dan daha kapsamlı bir Unicode metodudur. Ama Türkçeye özgü I / İ sorununu o da çözmez. “lower() yerine casefold() yazarsam Türkçe sorunu biter” diye düşünmeyin.
Programınızın Türkçe büyük/küçük harf kurallarına göre karşılaştırma yapması gerekiyorsa dönüşümü kendiniz yazabilirsiniz:
def turkce_kucult(metin):
    donusum = str.maketrans({"I": "ı", "İ": "i"})
    return metin.translate(donusum).lower()

assert turkce_kucult("İĞNE") == "iğne"
assert turkce_kucult("ISPARTA") == "ısparta"
Bu yardımcı fonksiyon önce Türkçeye özgü iki büyük harfi (I ve İ) kendisi küçültür, kalan harfler için de normal lower() kullanır.
Bu fonksiyonu her metne uygulamayın. E-posta alan adları, değişken ve fonksiyon adları ya da uluslararası kodlar Türkçe kurallar yerine başka kurallar gerektirebilir. Önce verinin hangi dilin kurallarına göre karşılaştırılacağına karar verin, sonra dönüşümü seçin.
İncele ve düzelt: temizlenmiş kullanıcı adı
Aşağıdaki kod kullanıcı adını temizlemeye çalışıyor, ama metotların döndürdüğü değeri hiçbir değişkene atamıyor:
Çıktının deniz olması için kodu düzeltin.
kullanici_adi = kullanici_adi.strip().lower() yazabilirsiniz.
kullanici_adi = "  DENIZ  "
kullanici_adi = kullanici_adi.strip().lower()

print(kullanici_adi)
in ile içerme kontrolü
Bir string’in başka bir string içerip içermediğini in ile kontrol edebiliriz:
eposta = "deniz@omu.edu.tr"

print("@" in eposta)
print("omu.edu.tr" in eposta)
print("gmail.com" in eposta)
Sonuçlar bool türündedir.
“Bu parça metnin içinde geçiyor mu?” ile “Metin bu parçayla mı bitiyor?” iki ayrı sorudur:
dosya = "rapor.pdf.bak"

print(".pdf" in dosya)          # True
print(dosya.endswith(".pdf"))   # False
Dosya uzantısını denetlerken işinize yarayan ikinci sorudur.
"@" in eposta ifadesinin True olması, metnin geçerli bir e-posta adresi olduğunu göstermez: "@@@" da bu kontrolden geçer. Basit bir kontrolü tam doğrulama sanmayın.
startswith(), endswith() ve replace()
Metnin başına ya da sonuna bakmak istiyorsanız in yerine bu iş için yazılmış metotları kullanın:
dosya = "rapor.pdf"

print(dosya.startswith("rapor"))
print(dosya.endswith(".pdf"))startswith(...): metin verilen başlangıçla mı başlıyor?endswith(...): metin verilen sonla mı bitiyor?
Metnin içindeki bir parçayı başka bir parçayla değiştirmek için replace() kullanılır. Sonuç yeni bir string’dir:
telefon = "0555 123 45 67"
temiz = telefon.replace(" ", "")
print(temiz)
Çıktı:
05551234567String’ler değiştirilemez olduğu için replace() de var olan string’i değiştirmez; sonucu bir değişkene atamak gerekir.
split() ile parçalama, join() ile birleştirme
Bir metni parçalara ayırmak için split() kullanılır. Parçaları birbirinden ayıran karaktere (örneğin virgüle) ayraç denir:
satir = "kalem,defter,silgi"
parcalar = satir.split(",")

print(parcalar)
Çıktı:
['kalem', 'defter', 'silgi']Argüman vermezsek split() metni boşluklardan böler; yan yana birden fazla boşluk varsa bunları tek ayraç sayar:
cumle = "Python ile metin işleme"
print(cumle.split())
Tersi için, yani parçaları bir ayraçla birleştirip tek bir string elde etmek için join() kullanılır:
kelimeler = ["Python", "ile", "metin", "işleme"]
sonuc = " ".join(kelimeler)
print(sonuc)
Çıktı:
Python ile metin işlemejoin() çağrısında soldaki string, parçaların arasına konacak ayraçtır.
split(",") içeriğini bildiğiniz basit metinlerde işe yarar. Gerçek CSV dosyalarında (değerlerin virgülle ayrıldığı tablo dosyaları) ise yanılabilir, çünkü bir alanın içinde de virgül ya da tırnaklı metin olabilir. 12. haftada bu iş için Python’ın csv modülünü kullanacağız.
String ve döngüler
Bir string üzerinde for ile karakter karakter gezebiliriz:
metin = "Python"

for karakter in metin:
    print(karakter)
Örneğin bir metindeki ASCII rakamlarını, yani 0–9 arasındaki rakamları sayalım:
kod = "BLP101"
rakam_sayisi = 0

for karakter in kod:
    if karakter >= "0" and karakter <= "9":
        rakam_sayisi = rakam_sayisi + 1

print(rakam_sayisi)
Burada "BLP101" içinde üç rakam vardır.
Python’da hazır .isdigit() metodu da vardır:
print("7".isdigit())
print("A".isdigit())
Bu metot yalnız tek karakterde değil, bütün bir string’de de çalışır ve string’in rakamlardan oluşup oluşmadığını söyler:
print("101".isdigit())  # True
print("10A".isdigit()) # False.isdigit(), 0–9 dışındaki bazı Unicode rakamları için de True döndürebilir (örneğin üs olarak yazılan "²"). Programınız yalnızca 0–9 rakamlarını kabul edecekse "0" <= karakter <= "9" gibi açık bir kontrol bu kuralı doğrudan yazar. Hazır bir metodu seçmeden önce, 7. haftadaki gibi, fonksiyonunuzun sözleşmesinin hangi karakterleri kabul ettiğine bakın.
Alıştırma: belirli karakteri sayın
Bir ürün kodunda kaç tane - karakteri bulunduğunu sayın.
Beklenen sonuç 3’tür.
if karakter == "-": koşulu içinde tire_sayisi değerini artırın.
urun_kodu = "TR-55-A-20"
tire_sayisi = 0

for karakter in urun_kodu:
    if karakter == "-":
        tire_sayisi = tire_sayisi + 1

print(tire_sayisi)
f-string ile okunabilir çıktı
Değişkenleri metnin içine yerleştirmenin okunaklı bir yolu f-string’dir: tırnaktan önce f yazılır, değişkenler süslü parantezin içine konur:
ad = "Deniz"
puan = 82

mesaj = f"{ad} adlı öğrencinin puanı: {puan}"
print(mesaj)
Süslü parantezlerin içine ifadeler de yazılabilir:
fiyat = 120
adet = 3

print(f"Toplam: {fiyat * adet} TL")
Sayıyı iki ondalık basamakla göstermek
2. haftadaki yakıt veya para hesaplarında 994.2400000000001 gibi uzun float çıktıları görebileceğimizi söylemiştik. F-string içinde .2f, sayıyı iki ondalık basamakla gösterir:
tutar = 994.2400000000001
print(f"Toplam: {tutar:.2f} TL")
Çıktı:
Toplam: 994.24 TLBaşka bir örnek:
oran = 3.5
print(f"Oran: {oran:.2f}")
Çıktı Oran: 3.50 olur.
.2f yalnızca sayının nasıl gösterileceğini belirler. tutar değerini metne çevirirken iki basamakla yazar; değişkenin bellekteki değeri değişmez ve kesin bir ondalık sayıya dönüşmez. 7. haftada testlerde tolerans kullanmamızın nedeni de buydu.
Bu derste f-string’i çoğunlukla ekrana yazdırırken kullanacağız. Uzun hesapları süslü parantezin içine yazmak yerine önce ayrı bir değişkende hesaplayın; kod daha kolay okunur.
Fonksiyonlarla metin normalleştirme
Aynı temizleme adımlarını birçok yerde kullanacaksak onları bir fonksiyona koyabiliriz:
def kullanici_adi_temizle(metin):
    return metin.strip().lower()

assert kullanici_adi_temizle("  DENIZ ") == "deniz"
assert kullanici_adi_temizle("Ayse") == "ayse"
Bu örnekteki kullanıcı adlarında Türkçeye özgü harf yok. Türkçe ürün, kişi ya da şehir adlarını büyük/küçük harfi önemsemeden eşleştirecekseniz yukarıdaki I / İ kuralını da hesaba katmalısınız.
Bu fonksiyon saftır: bir string alır, yeni bir string döndürür ve dışarıdaki hiçbir değeri değiştirmez.
Üret: basit kurumsal e-posta kontrolü
kurumsal_eposta_mi adlı bir fonksiyon yazın. Fonksiyon:
- Baştaki ve sondaki boşlukları temizlemeli,
- Metni küçük harfe çevirmeli,
- Metinde
@bulunup bulunmadığını kontrol etmeli, - Metnin
omu.edu.trile bitip bitmediğini kontrol etmeli.
Başlangıç kodu:
Beklenen çıktı:
True
False
Örneğin temiz = eposta.strip().lower() ile başlayabilirsiniz. Sonra "@" in temiz ve temiz.endswith("omu.edu.tr") koşullarını and ile birleştirin.
def kurumsal_eposta_mi(eposta):
    temiz = eposta.strip().lower()
    return "@" in temiz and temiz.endswith("omu.edu.tr")

print(kurumsal_eposta_mi("  DENIZ@OMU.EDU.TR "))
print(kurumsal_eposta_mi("deniz@gmail.com"))Bu fonksiyon yalnızca ders için basitleştirilmiş bir kontroldür. Gerçek e-posta adresi doğrulaması için daha ayrıntılı kurallar gerekir.
Tek sayfa özet
Bu hafta string’leri parçalara ayırdık, temizledik ve kontrol ettik.
- String indeksleri
0’dan başlar. - Negatif indeksler sağdan sayar; son karakter
metin[-1]ile alınabilir. len()karakter sayısını verir.- Dilimlemede başlangıç dâhil, bitiş hariçtir.
- String değerler değiştirilemez; metotlar yeni string döndürür.
strip(),lower()veupper()metni karşılaştırmadan önce ortak bir biçime getirir.lower()veupper()Türkçeye özgüI/İdönüşümünü yapmaz.casefold()büyük/küçük harfi önemsemeyen karşılaştırmalarda işe yarar ama TürkçeI/İsorununu çözmez.inbir parçanın metnin herhangi bir yerinde geçip geçmediğine bakar;startswith()veendswith()yalnızca başa ya da sona bakar.replace()bir parçası başka bir parçayla değiştirilmiş yeni bir string döndürür.split()metni parçalara ayırır,join()string parçaları bir ayraçla birleştirir.forile bir string’in karakterleri tek tek gezilebilir;.isdigit()bir string’in rakamlardan oluşup oluşmadığını söyler.- F-string değişkenleri metnin içine yerleştirir;
:.2fsayıyı iki ondalık basamakla gösterir. - Tekrarlanan temizleme ve kontrol adımları bir fonksiyona konabilir.
Bir sonraki bölümde birden fazla değeri birlikte tutmak için listeler ve demetler kullanacağız.
Bu bölümün kazanımları
Bu bölümü bitiren öğrenci:
- İndeks ve negatif indeksle karaktere erişir.
- Dilimlemede başlangıcın dâhil, bitişin hariç olduğunu uygular.
- String’in değiştirilemez olduğunu ve metotların yeni string döndürdüğünü gösterir.
strip(),lower()veupper()ile normalleştirir; TürkçeI/İsınırını bilir.in,startswith()veendswith()denetimlerini ayırır.split()vejoin()ile metni parçalar ve birleştirir.- F-string ile biçimlendirir ve
:.2fdavranışını açıklar.