İç içe kayıtlar ve küçük veri işleme
Geçen hafta bir ürünün ad, fiyat, stok bilgilerini bir sözlükte tutmayı gördük. Elimizde birden fazla ürün ya da öğrenci varsa her kaydı bir sözlüğe koyar, bu sözlükleri de bir listede saklarız.
Bu hafta yeni bir Python yapısı öğrenmeyeceğiz. Bildiğimiz liste, sözlük, koşul, döngü ve fonksiyonları birlikte kullanarak küçük veri kümeleriyle çalışacağız. Dört iş yapacağız: koşula uyan kayıtları seçmek (filtreleme), toplam ve ortalama almak (özetleme), en yüksek değerli kaydı bulmak (maksimum arama) ve kayıtları bölüm gibi bir alana göre ayırıp saymak (gruplama).
Bu bölümün kapsamı
liste[indeks]["alan"]erişiminin iki adımı- Filtreleme kalıbı ve
append()in kaydı kopyalamaması - Kayıtlar üzerinde sayma ve biriktirme ile özet çıkarma
- Maksimum aramada en büyük değerin ait olduğu kaydı tutma
- Sözlük anahtarlarıyla gruplama
- Metin alanlarını normalleştirmenin gruplama sonucunu nasıl değiştirdiği
- Eksik alan için varsayılan değeri problemin kuralına göre seçme
- Veri çerçevesi (tablo biçiminde veri tutan yapı) kullanan kütüphaneler
- İkiden çok seviyeli iç içe yapıların derin kopyası (içteki nesnelerin de kopyalanması)
Bu başlıklar konunun devamıdır; ileride karşınıza çıkar ama bu derste ezberlemeniz beklenmiyor.
Filtrelediğim kaydı değiştirince asıl liste neden bozuldu?
Geçen öğrencileri yeni bir listeye aldınız, sonra bu listedeki bir puanı değiştirdiniz. İlk listedeki puan da değişti. Çünkü bir kaydı başka bir listeye eklemek onu kopyalamaz; iki liste aynı sözlüğü paylaşır. Bu bölümde önce kayıtlara nasıl erişildiğini göreceğiz, sonra bu paylaşımın neye yol açtığına bakacağız.
Liste içinde sözlükler
Bir öğrenci kaydı:
ogrenci = {
    "ad": "Deniz",
    "bolum": "Bilgisayar",
    "puan": 78
}
Birden fazla öğrenci:
ogrenciler = [
    {"ad": "Deniz", "bolum": "Bilgisayar", "puan": 78},
    {"ad": "Ayşe", "bolum": "Siber", "puan": 92},
    {"ad": "Mert", "bolum": "Bilgisayar", "puan": 55}
]
Burada dış yapı bir liste, her eleman bir sözlüktür. Sözlükteki her anahtar-değer çifti kaydın bir alanıdır: ad, bolum, puan.
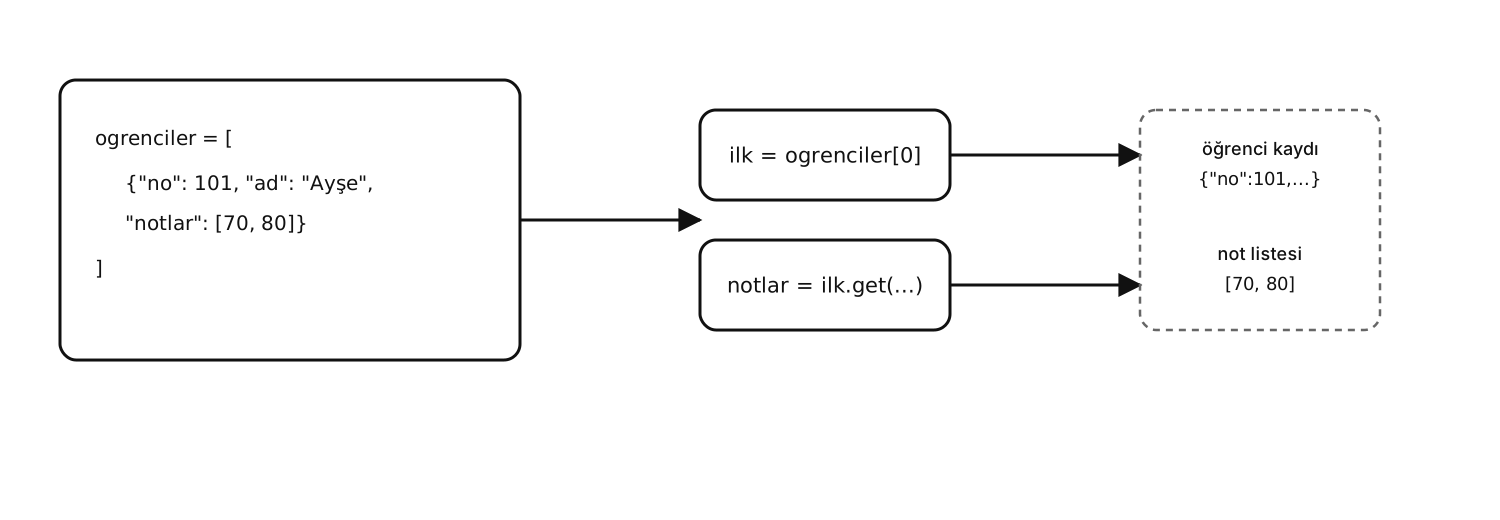
İlk öğrencinin puanı:
print(ogrenciler[0]["puan"])Python önce listenin 0 numaralı elemanını, yani ilk sözlüğü alır. Sonra o sözlüğün "puan" alanını okur.
Kayıtlar üzerinde gezinmek
for ogrenci in ogrenciler:
    print(ogrenci["ad"], ogrenci["puan"])
Döngünün her turunda ogrenci değişkeni listedeki sıradaki sözlüğü gösterir.
kayıt listesi
    ↓
her kaydı sırayla al
    ↓
alanlarını oku
    ↓
koşula göre işle
Tahmin et: hangi kayıtlar yazılır?
Çalıştırmadan önce hangi adların yazılacağını tahmin edin. Kod yalnızca stoku 0 olan ürünleri seçer. Koşula uyan kayıtları böyle seçmeye filtreleme denir.
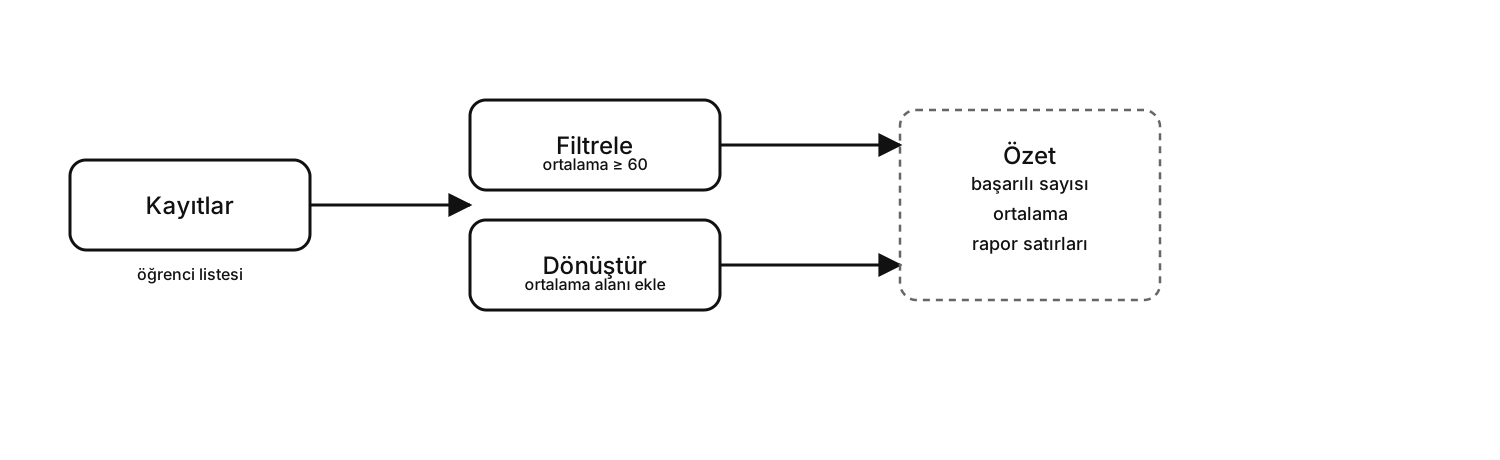
Filtreleme: koşulu sağlayan kayıtları seçmek
ogrenciler = [
    {"ad": "Deniz", "puan": 78},
    {"ad": "Ayşe", "puan": 92},
    {"ad": "Mert", "puan": 55}
]

gecenler = []

for ogrenci in ogrenciler:
    if ogrenci["puan"] >= 60:
        gecenler.append(ogrenci)

print(gecenler)
gecenler listesinde yalnızca puanı 60 ve üzeri olan kayıtlar bulunur.
Filtrelenen sözlükler kopyalanmaz
9. haftada gördüğümüz aliasing (iki adın aynı nesneyi göstermesi) burada yine karşımıza çıkıyor. gecenler.append(ogrenci) yeni bir sözlük oluşturmaz; listeye var olan sözlüğe giden bir referans ekler.
ogrenciler = [
    {"ad": "Deniz", "puan": 78},
    {"ad": "Ayşe", "puan": 92}
]

gecenler = []
for ogrenci in ogrenciler:
    if ogrenci["puan"] >= 60:
        gecenler.append(ogrenci)

gecenler[0]["puan"] = 0

print(ogrenciler[0]["puan"])  # 0
gecenler[0] ile ogrenciler[0] aynı sözlük nesnesini gösterdiği için değişiklik iki listeden de görünür.
Asıl kaydı değiştirmeden ayrı bir kayıt istiyorsanız listeye sözlüğün sığ kopyasını (shallow copy) ekleyin:
gecenler.append(ogrenci.copy()).copy() yalnızca sözlüğün kendisini kopyalar. Sözlüğün içinde liste gibi değiştirilebilir bir değer varsa o değer iki kopya arasında ortak kalır. Bu bölümdeki kayıtlarda değerler yalnızca sayı ve metin olduğu için sığ kopya yeterlidir.
Alıştırma: düşük stok kayıtlarını seçin
Stoku 5 ve altında olan ürünleri dusuk_stok listesine ekleyin. Listede Defter ve Silgi kayıtları bulunmalıdır.
if urun["stok"] <= 5: koşulu içinde dusuk_stok.append(urun) kullanabilirsiniz.
urunler = [
    {"ad": "Kalem", "stok": 12},
    {"ad": "Defter", "stok": 3},
    {"ad": "Silgi", "stok": 5},
    {"ad": "Cetvel", "stok": 8}
]

dusuk_stok = []

for urun in urunler:
    if urun["stok"] <= 5:
        dusuk_stok.append(urun)

print(dusuk_stok)
Özetleme: toplam ve ortalama
Her kaydın aynı alanını bir değişkende toplayabiliriz (biriktirme):
satislar = [
    {"urun": "Kalem", "tutar": 120},
    {"urun": "Defter", "tutar": 250},
    {"urun": "Silgi", "tutar": 80}
]

toplam = 0
for satis in satislar:
    toplam = toplam + satis["tutar"]

print(toplam)  # 450
Ortalama için toplam / len(satislar) yazabiliriz. Ama liste boşsa len(satislar) sıfır olur ve bölme hata verir. Bu durumu ayrıca düşünmek gerekir.
Boş liste için ortalama ne döndürmeli?
Boş bir öğrenci listesinde ortalama olarak 0 döndürmek ilk bakışta makul görünebilir. Ama şu iki durum birbirinden farklıdır:
[]→ hiç puan yok,[0]→ bir öğrenci var ve puanı gerçekten0.
İkisinde de 0 döndürürsek aradaki fark kaybolur. Bu yüzden fonksiyonun sözleşmesine boş liste için ayrı bir kural koyuyoruz:
def puan_ortalamasi(ogrenciler):
    if len(ogrenciler) == 0:
        return None

    toplam = 0
    for ogrenci in ogrenciler:
        toplam = toplam + ogrenci["puan"]

    return toplam / len(ogrenciler)
Sözleşme:
Çıktı:
- liste boşsa None: hesaplanabilecek ortalama yok
- değilse puanların sayısal ortalaması
Fonksiyonu çağıran kod bu durumu kontrol eder:
ortalama = puan_ortalamasi([])

if ortalama is None:
    print("Ortalama hesaplanamadı: veri yok")
else:
print("Ortalama:", ortalama)None değerini ve is None kontrolünü 6. haftada gördük. Bir fonksiyonun sorunu None döndürerek bildirmesinin artılarını ve eksilerini 13. haftada ayrıntılı konuşacağız. Buradaki karar şu: veri yoksa sonuç bir sayı olmamalı.
Maksimum arama: yalnızca değeri değil, kaydı bulmak
9. haftada bir sayı listesinde “şimdiye kadarki en yüksek” değeri tutan kalıbı gördük. Kayıtlarda aynı kalıpla en yüksek puanın ait olduğu sözlüğü buluruz:
def en_yuksek_puanli(ogrenciler):
    if len(ogrenciler) == 0:
        return None

    en_yuksek = ogrenciler[0]

    for ogrenci in ogrenciler[1:]:
        if ogrenci["puan"] > en_yuksek["puan"]:
            en_yuksek = ogrenci

    return en_yuksek
Örnek:
ogrenciler = [
    {"ad": "Deniz", "puan": 78},
    {"ad": "Ayşe", "puan": 92},
    {"ad": "Mert", "puan": 55}
]

print(en_yuksek_puanli(ogrenciler))
Fonksiyon Ayşe’nin kaydını, yani {'ad': 'Ayşe', 'puan': 92} sözlüğünü döndürür. 14. haftada “en çok ciro yapan ürün”ü bulurken de bu kalıbı kullanacağız.
max() bir sayı listesindeki en büyük değeri tek satırda bulur. Veri sözlüklerden oluşuyorsa başlangıçta döngüyü kendiniz yazın. Böylece hangi alanın karşılaştırıldığını ve hangi kaydın tutulduğunu kodda açıkça görürsünüz.
Alıştırma: toplam stok fonksiyonu
Döngüde her ürünün stok değerini toplama ekleyin. Beklenen sonuç 20’dir.
Döngü içinde toplam = toplam + urun["stok"] yazabilirsiniz.
def toplam_stok(urunler):
    toplam = 0

    for urun in urunler:
        toplam = toplam + urun["stok"]

    return toplam
Basit gruplama
Kayıtları bir alana göre gruplamak için sözlük kullanırız. Aşağıdaki kod her bölümde kaç öğrenci olduğunu sayar; bölüm adı anahtar, öğrenci sayısı değer olur:
ogrenciler = [
    {"ad": "Deniz", "bolum": "Bilgisayar"},
    {"ad": "Ayşe", "bolum": "Siber"},
    {"ad": "Mert", "bolum": "Bilgisayar"},
    {"ad": "Ece", "bolum": "Siber"},
    {"ad": "Can", "bolum": "Bilgisayar"}
]

bolum_sayilari = {}

for ogrenci in ogrenciler:
    bolum = ogrenci["bolum"]
    bolum_sayilari[bolum] = bolum_sayilari.get(bolum, 0) + 1

print(bolum_sayilari)
Beklenen:
{'Bilgisayar': 3, 'Siber': 2}Geçen hafta bir listedeki şehirlerin kaç kez geçtiğini böyle saymıştık (frekans sayımı). Burada aynı kalıbı kayıtların bir alanına uyguluyoruz.
Gruplama anahtarı gerçekten aynı mı?
Metin alanlarını anahtar yaptığımızda "Siber", "siber" ve " SİBER " sözlük için üç ayrı anahtardır. Üçü aynı bölümü anlatıyorsa önce hepsini aynı biçime getiren açık bir kural koymalısınız. Buna normalleştirme denir:
bolum = ogrenci["bolum"].strip().lower()Veride Türkçe harf yoksa bu yeterli olabilir. Ama 8. haftada gördüğümüz gibi lower(), Türkçe I / İ dönüşümünü Türkçe kurala göre yapmaz. "İdari" ile "IDARI" gibi değerlerin aynı sayılıp sayılmayacağına verinin ait olduğu problem karar verir.
Gruplamadan önce “biraz temizleyelim” diye her değere körlemesine lower() uygulamayın. Hangi yazımların aynı sayılacağına siz karar vermelisiniz. Türkçe ad, bölüm, ürün ve şehir adlarında 8. haftadaki normalleştirme uyarısını hatırlayın.
Her grubun toplamını bulmak
Aynı kalıpla her grubun kayıt sayısı yerine tutarlarının toplamını da tutabiliriz:
satislar = [
    {"kategori": "Kırtasiye", "tutar": 120},
    {"kategori": "İçecek", "tutar": 50},
    {"kategori": "Kırtasiye", "tutar": 80}
]

kategori_toplamlari = {}

for satis in satislar:
    kategori = satis["kategori"]
    tutar = satis["tutar"]
    kategori_toplamlari[kategori] = kategori_toplamlari.get(kategori, 0) + tutar

print(kategori_toplamlari)
Sonuç:
{'Kırtasiye': 200, 'İçecek': 50}Eksik alan ve get()
Bir kayıtta alanın bulunmaması iki farklı anlama gelebilir:
urun = {"ad": "Kalem"}Bu kayıtta urun["stok"] yazarsanız KeyError alırsınız. urun.get("stok", 0) ise hata vermez, 0 döndürür. Ama bu ancak problemde stok bilgisi olmayan ürünün stoku sıfır sayılıyorsa doğrudur.
Başka bir problemde eksik alan, verinin hatalı girildiğini gösterebilir. O zaman sessizce 0 koymak yanlış sonucu gizler.
get() hatayı önler ama doğru varsayılan değeri sizin yerinize seçmez; onu problemin kuralı belirler. Program hata vermedi diye veri doğru işlenmiş olmaz.
İç içe yapıyı izlemek
İç içe bir ifadeyi soldan sağa, adım adım okuyun:
ogrenciler[1]["puan"]Adımlar:
ogrenciler[1]→ ikinci öğrenci sözlüğü["puan"]→ o sözlükteki puan değeri
Uzun bir ifadeyi tek bakışta çözmeye çalışmak yerine böyle parça parça okursanız daha az yanılırsınız.
Değiştir: rapora yeni alan ekleyin
Bu kod listedeki sözlüklerin kendisini değiştirir, kopya almaz. Bu kayıtları daha önce gecenler.append(ogrenci) ile başka bir listeye eklemiş olsaydınız yeni gecti alanını o listede de görürdünüz. Asıl veri değişmemeliyse ogrenci.copy() ile kopya alıp onu değiştirin ya da her kayıt için yeni bir sözlük oluşturun.
Üret: bölüm başına puan toplamı
Fonksiyon her bölümün puan toplamını bir sözlükte döndürmeli. Beklenen:
{'Bilgisayar': 140, 'Siber': 160}Döngü içinde bolum, puan değerlerini alın; sonra toplamlar[bolum] = toplamlar.get(bolum, 0) + puan kullanın.
def bolum_puan_ozeti(ogrenciler):
    toplamlar = {}

    for ogrenci in ogrenciler:
        bolum = ogrenci["bolum"]
        puan = ogrenci["puan"]
        toplamlar[bolum] = toplamlar.get(bolum, 0) + puan

    return toplamlar
Veri işleme akışını parçalamak
Küçük bir veri problemine şu sırayla yaklaşabilirsiniz:
veriyi tanı
    ↓
hangi kayıtlar gerekli?
    ↓
hangi alanlar kullanılacak?
    ↓
filtrele / say / biriktir / maksimumu bul / grupla
    ↓
sonucu açık bir yapıda döndür
Bütün bu adımları tek bir fonksiyona yığmayın. İşi gecen_ogrenciler, puan_ortalamasi ve en_yuksek_puanli gibi, her biri tek iş yapan fonksiyonlara bölün.
Tek sayfa özet
- Bir kaydı sözlükte, kayıtların hepsini bir listede tutarız.
liste[indeks]["alan"]önce kaydı, sonra alanı seçer.- Filtreleme, koşulu sağlayan kayıtları yeni bir listeye eklemektir.
append(ogrenci)sözlüğü kopyalamaz; iki liste aynı sözlüğü paylaşır. - Ayrı bir kayıt gerekiyorsa
ogrenci.copy()kullanılır. Değerleri sayı ve metin olan kayıtlar için bu sığ kopya yeterlidir. - Özetlemede bir alanın değerleri sayılır ya da toplanır.
- Liste boşsa
Nonedöndürmek, “veri yok” durumunu gerçekten0olan bir sonuçtan ayırır. - Maksimum aramada en büyük sayıyla birlikte o sayının ait olduğu kayıt da tutulabilir.
- Gruplamada grup adı sözlüğün anahtarı, sayı ya da toplam ise değeri olur.
- Metin alanlarında gruplamanın sonucu seçilen normalleştirme kuralına bağlıdır. Türkçe
I/İharflerine özellikle dikkat edin. get(grup, 0)bir grubun sayacını ya da toplamını başlatmak için kullanışlıdır. Eksik bir alanın varsayılan değerini ise problemin kuralı belirler.- Veri işleme kodunu tek iş yapan küçük fonksiyonlara bölerseniz her parçayı ayrı ayrı sınayabilirsiniz.
Bir sonraki bölümde bu kayıtları bir dosyadan okuyacak, sonuçları dosyaya yazacağız: konu dosyalar ve CSV.
Bu bölümün kazanımları
Bu bölümü bitiren öğrenci:
liste[indeks]["alan"]erişimini iki adımda çözümler.- Filtreleme kalıbını kurar ve
append()in kaydı kopyalamadığını bilir. - Kayıtlar üzerinde sayma ve biriktirmeyle özet çıkarır.
- Maksimum aramada en büyük değerle birlikte o değerin ait olduğu kaydı tutar.
- Sözlük anahtarlarıyla gruplama yapar.
- Metin alanlarında normalleştirme kuralının gruplama sonucunu belirlediğini açıklar.
- Eksik alan için varsayılan değeri problemin kuralına göre seçer.